
ช่วงนี้มีเทรนด์ AI ใหม่ตัวหนึ่ง ที่ไม่ได้ใช้คุยกับมนุษย์ปกติทั่วไป แต่มีไว้ให้ซอฟต์แวร์ถามแล้วได้คำตอบที่โค้ดเอาไปใช้ต่อได้
ตัวที่ผมลองชื่อว่า Jev เป็นโมเดลของ TypeSafe AI ที่รับข้อมูลเข้าไป แล้วตอบกลับมาเป็นค่าที่มีชนิดชัดเจน เช่น เลือกหนึ่งตัวเลือก (Choice) ให้คะแนน (Score) หรือคืนความน่าจะเป็นของคำตอบใช่หรือไม่ใช่ (Noul) ผมเลยเอามันทดลองกับโจทย์ใกล้ตัวมากๆ คือการคัด Lead ปลอมที่ได้มาจากการลงทะเบียน โดยใช้ข้อมูลจริง 788 ราย ที่ทีมผมเคยพิจารณาตรวจคำตอบไว้ก่อนหน้านั้นแล้ว
ผลออกมาค่อนข้างน่าสนใจพอสมควร เลยแชร์ไว้เผื่อเป็นประโยชน์ครับ
หมายเหตุ: เอเจ้นชมพูช่วยถอดความและเรียบเรียงบทความนี้จากบันทึก โค้ด และผลการทดลองจริงของฟิวส์
หมายเหตุเรื่องข้อมูล: ตัวอย่างชื่อทั้งหมดในบทความเป็นชื่อสมมติที่สร้างให้มีคุณสมบัติทางภาษาเหมือนข้อมูลจริง ไม่ได้นำชื่อจากไฟล์ลูกค้ามาเผยแพร่ เพราะแม้แถวที่ถูกตัดสินว่าเป็น spam ก็ยังอาจเป็นชื่อของคนจริง
สรุปไฮไลต์สั้นๆ
- Jev คืนค่าแบบ typed output โค้ดใช้ผลลัพธ์ต่อได้โดยไม่ต้องแกะข้อความหรือหวังว่า JSON จะไม่พัง
- ทดสอบกับลีดจริง 788 ราย ครอบคลุมข้อมูล 38 สัปดาห์ และผมมีเฉยๆ ของมนุษย์ครบทุกแถว เพื่อไว้ Cross Check แล้ว
- ระบบตัดสินเองได้ 66.4% บนชุดทดสอบชุดแรก (312 ราย) โดยกลุ่มที่ระบบตัดเป็น spam เองไม่มีลีดจริงปะปน 0 จาก 28 ราย
- Probability calibration ทำได้ดีขึ้น ค่าที่ใช้วัดความแม่นยำของความน่าจะเป็น (ECE) อยู่ที่ 0.065 จึงอยู่ในระดับที่ใช้ตั้ง threshold กับข้อมูลชุดนี้ได้
- ไม่แนะนำให้ AI ทำแทน deterministic logic เรื่องรูปแบบอีเมล ตัวเลขในชื่อ หรือประวัติในฐานข้อมูล เราเขียนโค้ดและเช็คฐานข้อมูลเองได้ ถูกกว่า
Jev คืออะไร และต่างจาก LLM ที่เราใช้กันอย่างไร
Jev คือโมเดลตัวแรกที่ TypeSafe AI พัฒนาขึ้นมา เรียกว่า System One model ชื่อนี้ยืมแนวคิด System 1 และ System 2 ที่ Daniel Kahneman ทำให้คนรู้จักผ่านหนังสือ Thinking, Fast and Slow
System 1 คือการตัดสินใจเร็วๆ แบบที่สมองทำอัตโนมัติ
ส่วน System 2 คือการคิดใคร่ครวญทีละขั้น
Jev ถูกออกแบบมาสำหรับการตัดสินใจแบบแรก คือถามเรื่องแคบๆ ให้ชัด แล้วคืนคำตอบที่ software ใช้ต่อได้ทันที
ซอฟต์แวร์ไม่ได้อยากได้ข้อความยาวๆ ซอฟต์แวร์อยากได้คำตอบที่เอาไป branch, sort, threshold หรือ route ต่อได้เลย
ถ้าเราถาม LLM ว่า lead รายนี้เป็นของปลอมไหม แล้วได้คำตอบว่า จากข้อมูลที่ให้มามีความเป็นไปได้ค่อนข้างสูง เราต้องเขียนโค้ดแกะข้อความอีกชั้น และมีโอกาสพังวันที่โมเดลเปลี่ยนสำนวนการตอบ
Jev ไม่เขียนคำอธิบายแบบนั้นครับ มันรับ state แล้วคืน typed answers กับ probability distribution ตามชนิดคำถามที่เรากำหนดไว้ เอกสารของ TypeSafe แบ่ง primitive ออกเป็น 3 แบบ
| แบบคำถาม | ใช้ถามอะไร | ค่าที่ได้กลับมา |
|---|---|---|
| Choice | เลือก 1 จากตัวเลือกที่กำหนด | ตัวเลือกที่เลือก ความน่าจะเป็นทุกตัวเลือก และ confidence |
| Score | ให้คะแนนตามระดับที่เรียงไว้ | คะแนน legend ความน่าจะเป็นแต่ละระดับ และ confidence |
| Noul | คำถามใช่หรือไม่ใช่ | ตัวเลข 0 ถึง 1 ซึ่งเป็นความน่าจะเป็นที่คำตอบคือใช่ |
ตัวอย่างจาก Python SDK จะประมาณนี้
from typesafe_sdk import Choice, Noul, TypeSafeClient

with TypeSafeClient() as client:
    result = client.system_one(
        state={"message": "ผมโดนเรียกเก็บเงินซ้ำสองรอบ ช่วยแก้ด่วนเลยครับ"},
        questions={
            "department": Choice(
                instructions="ทีมไหนควรรับเรื่องนี้",
                criteria={
                    "billing": "เรื่องการเงิน",
                    "technical": "เรื่องระบบ",
                },
            ),
            "is_urgent": Noul(
                instructions="ข้อความนี้แสดงความเร่งด่วน"
            ),
        },
    )

print(result.choices["department"].choice)
print(result.choices["department"].confidence)
print(result.nouls["is_urgent"].noul)
จุดที่ผมชอบคือไม่ต้อง regex ข้อความ ไม่ต้องลุ้นว่าโมเดลจะครอบ JSON ด้วย markdown หรือใส่คำอธิบายเกินมา โค้ดรู้ตั้งแต่ต้นว่าจะได้ข้อมูลรูปแบบไหนกลับมา
Probability กับ confidence ไม่ใช่ค่าเดียวกัน
ตามเอกสารของ TypeSafe ค่า probability บอกการกระจายของคำตอบ ส่วน confidence เป็นสถิติที่สรุปว่าการกระจายนั้นมีคำตอบที่ควรจะใช่ ชัดแค่ไหน และมีเฉพาะ Choice กับ Score ส่วน Noul คืน probability โดยตรง ไม่มี confidence แยกอีกตัว
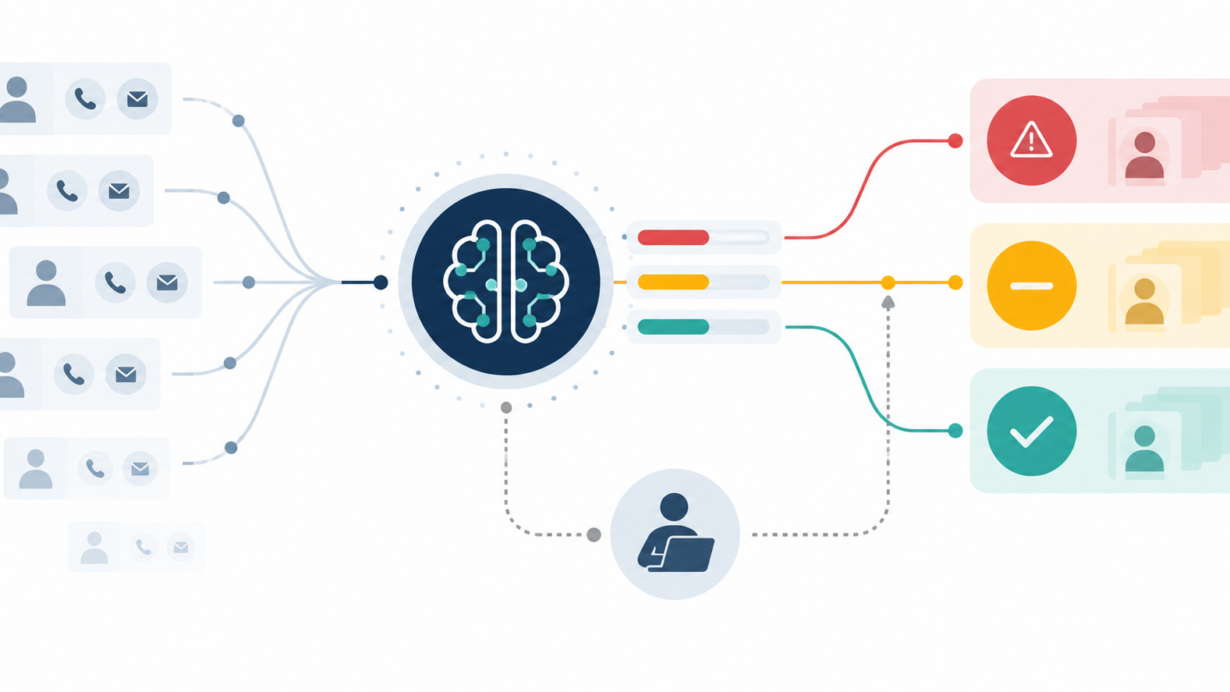
แนวคิดนี้เอาไปสร้างระบบแบบ confidence-gated routing ได้ เช่น confidence สูงให้ทำอัตโนมัติ confidence กลางส่งให้คนตรวจ และ confidence ต่ำไม่ให้ระบบเดา แต่ค่าตัดตรงไหนต้องวัดจากข้อมูลของงานเราเอง ไม่ควรหยิบเลขจากตัวอย่างใน docs มาใช้ตรงๆ
โจทย์ที่เอามาทดลองคือ Fake Lead
เว็บไซต์ที่ผมหยิบมาทดสอบ มีฟอร์มให้คนสนใจกรอกข้อมูล แล้วส่งลีดต่อให้ทีมขายโทรติดตาม ปัญหาคือมีทั้งลูกค้าจริงที่กรอกข้อมูลแปลกๆ คนก่อกวน และบอท
ระบบเดิมมี rule คอยดักไว้ชั้นหนึ่ง เช่น ชื่อมีตัวเลข ชื่อยาวเกิน xx ตัวอักษร อีเมลผิดรูปแบบ หรือเบอร์เคยอยู่ในฐาน spam จากนั้นถ้าเจอว่าก้ำกึ่งๆ ให้คนนั่งตรวจทีละราย
ข้อมูลที่ผมใช้ทดลองมาจากผลการตรวจจริง 38 สัปดาห์ รวม 788 ราย ทุกแถวมีคำตัดสินของคนกำกับไว้ทุกรายการก่อนแล้ว (แต่ผมไม่ส่งเฉลยให้ Jev นะ)
ตัวเลขแรกก็สะดุดแล้วครับ จาก 788 รายที่ระบบกฎดักไว้ คนตัดสินว่าไม่ใช่ spam ถึง 542 ราย หรือ 68.8% แปลว่างานตรวจส่วนใหญ่คือการยืนยันว่ากฎดักผิด
เหตุผลที่เจอบ่อยที่สุดคือ Numbers found in name จำนวน 305 ราย และเกือบทั้งหมดเป็นลีดจริง ตัวอย่างรูปแบบสมมติจะเป็นแบบนี้
38-605 สมหญิง ใจดี
สุภาพร 05
10 สมชาย รักดี
คนเหล่านี้อาจลืมาสลับแป้น เผลอกรอกผิด หรือเอาเลขที่บ้าน เลขลำดับ หรือข้อมูลบางอย่างไปใส่รวมกับชื่อ แต่ก็ยังเป็นคนจริงที่ติดต่อได้ ระบบกฎเห็นแค่รูปแบบผิด ส่วนคนตรวจมองเจตนาและบริบทออก
แกนที่กฎแยกไม่ออก คือคนจริงที่กรอกมั่ว กับคนที่ตั้งใจปลอมตัวตน
แยกสิ่งที่คำนวณได้ ออกจากสิ่งที่ต้องใช้ judgment
เงื่อนไขที่ทีมให้มามี 12 ข้อ แต่พอดูจริงๆ แล้วส่วนใหญ่ไม่ใช่คำถามสำหรับ AI เลยครับ อีเมลผิดรูปแบบไหม ชื่อมีตัวเลขไหม เบอร์ยาวเกิน xx หลักไหม โค้ดธรรมดาตอบได้แม่นกว่า เร็วกว่า และฟรี
ข้อมูลลีด
  └─ โค้ดคำนวณข้อเท็จจริง 23 ตัว
       └─ ส่ง facts ให้ Jev ตัดสินส่วนที่ต้องใช้ judgment
            └─ โค้ดใช้ threshold และ confidence ตัดสินว่าจะทำเองหรือส่งให้คน
ผมให้ Jev ตอบ Choice 3 ทาง
spamตั้งใจปลอมlow_quality_but_realเป็นคนจริง แต่กรอกข้อมูลเลอะlegitimateลีดปกติ
ที่ไม่ใช้แค่ spam กับ not spam เพราะสองตัวเลือกนั้นบีบให้โมเดลทิ้งข้อมูลสำคัญพอดี กลุ่มที่ระบบเดิมมีปัญหาคือคนจริงที่กรอกมั่ว ถ้าไม่มี class ตรงกลาง โมเดลก็ต้องยัดคนเหล่านี้ไปฝั่งใดฝั่งหนึ่ง
ทำไมไม่เขียนกฎเพิ่มไปเรื่อยๆ
ผมลองแล้วครับ และมันสอนบทเรียนค่อนข้างแพงทางเวลา ฮาาา
การทดลองแรกคือเอาถังคำหยาบภาษาไทยและอังกฤษ 173 คำไปค้นในชื่อทั้ง 788 ราย พบ 11 ราย แต่ 10 รายในนั้น คนยืนยันว่าไม่ใช่ spam
| รูปแบบชื่อ ตัวอย่างสมมติ | ไปตรงกับคำว่า | สาเหตุที่ไม่ควรตัดสินทันที |
|---|---|---|
| Somsak Theechai | hee | นามสกุลไทยที่ถอดเสียงมีพยางค์ -hee- |
| Marco Grassano | ass | นามสกุลอิตาลีลงท้าย -assano |
| Rapee7 สุขใจ | rape | ชื่อ ระพี ถอดเสียงเป็น Rapee |
| สมหญิง ทรงกูล | กู | นามสกุลลงท้ายด้วย กูล |
ถังคำหยาบมีคำอย่าง อี กู ขี้ หน้า แม่ ซึ่งเป็นพยางค์ปกติในชื่อคนไทยได้ การ match substring ตรงๆ จึงเหมือนเอาตะแกรงช่องใหญ่ไปกรองทราย เม็ดที่ไม่เกี่ยวติดมาด้วยเต็มไปหมด
การทดลองที่สองคือเขียน detector หกรูปแบบ เช่น อักษรซ้ำ ชื่อเหมือนนามสกุล และ keyboard smash มันจับตัวอย่าง spam ที่ทีมให้มาได้ 16 จาก 17 ราย ฟังดูดีมาก
แต่พอใช้กับข้อมูลจริง มันไปโดนคนที่ไม่ใช่ spam 91 จาก 542 ราย หรือ 16.8% ตัวอย่างสมมติคือนามสกุลแบบ Chaichanachai ที่โดนเพราะพยางค์ cha ซ้ำสี่ครั้ง
Signal เป็นหลักฐาน ไม่ใช่คำตัดสิน หน้าที่ของมันคือบอกว่าเราเห็นอะไร แล้วให้ระบบชั่งน้ำหนักร่วมกับบริบทอื่น
ผลทดลองบนข้อมูลที่ไม่เคยใช้เลือก threshold
ผมแบ่งข้อมูลตามเวลา โดยใช้สัปดาห์ 1 ถึง 26 จำนวน 476 รายสำหรับเลือก threshold, แล้ววัดผลจริงบนสัปดาห์ 27 ถึง 38 อีก 312 รายที่ไม่เคยถูกใช้เลือกอะไรเลย
การแบ่งตามเวลาสำคัญมาก เพราะระบบจริงไม่ได้สุ่มอดีตและอนาคตมาปนกัน เราตั้งเกณฑ์จากอดีตแล้วเอาไปใช้กับข้อมูลที่เข้ามาทีหลัง
| ตัวชี้วัดบนชุดทดสอบ 312 ราย | ผล และช่วงเชื่อมั่น 95% |
|---|---|
| ตัดสินเองได้โดยไม่ต้องให้คนดู | 66.4% (60.9 ถึง 71.4%) |
| ผิดพลาด ที่ไปตัดลีดจริงทิ้ง | 0% หรือ 0 จาก 28 ราย |
| จับ spam ได้ครบแค่ไหน | 47.8% (37.8 ถึง 58.0%) |
| ผิดพลาด ที่ปล่อย spam ผ่านเข้าระบบ | 14.0% (9.6 ถึง 19.8%) |
| ค่าความคลาดของความน่าจะเป็น ECE | 0.065 |
เลขที่สำคัญที่สุดสำหรับผมคือ 0 จาก 28 ราย เพราะต้นทุนของความผิดสองแบบไม่เท่ากัน การตัดลูกค้าจริงทิ้งคือเสียโอกาสขายไปเลย ส่วนการปล่อย spam ผ่านคือทีมขายเสียเวลาโทร
แต่ต้องอ่านให้ครบครับ 0 จาก 28 ไม่ได้แปลว่าอัตราผิดจริงคือศูนย์ เพราะขอบบนของช่วงเชื่อมั่นยังอยู่ที่ 12.1% จากฐานข้อมูลแค่ 28 ราย อาจจะยังเล็กเกินกว่าจะสรุปว่า Jev มี error rate ต่ำกว่า 1% ซึ่งคงต้องหาข้อมูลมาเพิ่มเติมทดสอบใหม่
Probability calibration รอบนี้ดีขึ้นจนใช้ตั้งเกณฑ์ได้
ค่า Expected Calibration Error (ECE) ซึ่งใช้วัดว่าความน่าจะเป็นที่โมเดลรายงานตรงกับอัตราที่เกิดจริงแค่ไหน ออกมาที่ 0.065 ถือว่าดีสำหรับข้อมูลชุดนี้
พูดแบบง่ายๆ เวลาโมเดลตอบ 0.8 อัตราที่เกิดจริงอยู่ตั้งแต่ 0.74 ถึง 0.87 ตัวเลขจึงเชื่อถือได้ในระดับที่เอาไปตั้ง threshold สำหรับข้อมูลชุดนี้ได้
ถึงตัวเลขรอบนี้จะดีขึ้น หลักเดิมยังเหมือนเดิมครับ ต่อให้ผู้ผลิตบอกว่าโมเดลถูกฝึกเรื่อง calibration มา เราก็ต้องวัดกับ domain, ภาษา และข้อมูลของตัวเองก่อนตั้งเกณฑ์ใช้งานจริง
Jev ทำอะไรได้ และอะไรควรปล่อยให้ฐานข้อมูลทำ
พอผมให้รันเหมือนระบบจริงทั้ง 788 ราย โดยจะมีเงื่อนไขตรวจสอบตามกฎ และส่งผลลัพธ์การตรวจพร้อมชื่อ เบอร์โทร อีเมล วันที่กรอกฟอร์ม ให้ Jev พิจารณาต่อแทนคน ผลลัพธ์ที่ได้น่าสนใจมาก คือ
| เหตุผลที่คนเขียน | จำนวน | Jev ระบุเหตุผลตรงกันกับคน |
|---|---|---|
| ติดต่อได้ เป็นคนจริง | 421 | 98.3% (Jev ไม่ได้ติดต่อคนจริงๆ นะ ดูจากข้อมูลเท่านั้น) |
| เป็นข้อมูลทดสอบ | 16 | 100% (มีอยู่ผลลัพธ์คัดกรองหลายๆ ข้อ ที่ส่งให้ Jev) |
| ลงทะเบียนซ้ำหลายครั้ง | 92 | 3.3% (โค้ดประมวลผลจากวันที่กรอกฟอร์ม และส่งให้ Jev) |
| เคยอยู่ในฐาน spam | 212 | 0% (โค้ดและ Jev ตรวจสอบไม่ได้ เพราะผมไม่ได้จำลองข้อมูลไว้ให้) |
known_spam_record ร่วงเป็น 0% และนี่ไม่ใช่ความผิดของโมเดล เราไม่สามารถรู้ว่าเบอร์หนึ่งเคยเป็น spam ด้วยการมองตัวเลข ต้อง query ฐานข้อมูล คนตรวจมีฐานนั้น แต่ Jev ไม่มี
การเช็คประวัติจึงเป็นงานของ database กับ deterministic rule เพราะเร็ว แม่น และ audit ได้ ส่วนการตัดสินว่าข้อมูลชุดนี้ดูเป็นคนจริงที่ติดต่อได้หรือเป็นการปลอมตัวตน เป็นงานที่ Jev ช่วยได้ดีกว่า
นี่อธิบายด้วยว่าทำไม recall ฝั่ง spam อยู่เพียงราว 48% เพราะ 85% ของสิ่งที่คนเรียกว่า spam ในข้อมูลชุดนี้เป็นเคสที่อาศัยประวัติจากฐานข้อมูลล้วนๆ
จุดที่ผมคิดว่าคุ้มที่สุดคือใช้ Jev ช่วยจัดการ 305 รายที่ rule ดักเพราะชื่อมีตัวเลข ซึ่งปัจจุบันคนต้องคอยตรวจและยืนยันทีละราย
ค่าใช้จ่ายถูกจนไม่ใช่ปัจจัยตัดสินใจ
| ประมวลผล 788 ราย | $0.042 หรือประมาณ 1.5 บาท |
|---|---|
| ค่าใช้จ่ายต่อราย | $0.0000525 |
| ปริมาณจริงประมาณ 21 รายต่อสัปดาห์ | ประมาณ $0.06 ต่อปี |
ต้นทุนทั้งปีถูกกว่ากาแฟหนึ่งแก้วอีกครับ ทำให้ผมปรับคำถาม ปรับ threshold แล้วรันข้อมูลทั้งชุดใหม่ได้หลายรอบโดยไม่ต้องกังวลเรื่องค่า API
แต่ราคาถูกไม่ได้แปลว่าควรใช้ทุกที่ ถ้าโค้ดหรือ SQL ตอบได้ตรงๆ ต่อให้ AI ฟรีก็ยังเป็นทางเลือกที่ซับซ้อนกว่า
ถ้าจะเอา Jev ไปใช้จริง ผมจะเริ่มแบบนี้
- เลือก judgment ที่แคบและชัด เช่น intent, routing, risk tier หรือข้อมูลดูเป็นคนจริงหรือไม่ ไม่โยนโจทย์กว้างให้วิเคราะห์ทุกอย่าง
- แยก deterministic facts ออกมาก่อน ใช้ code, regex, database และ validation สำหรับเรื่องที่ตอบแน่นอนได้
- มนุษย์ควรมายืนยันความน่าเชื่อถือ และเก็บเหตุผลไว้ด้วย เพราะ accuracy อย่างเดียวบอกไม่พอว่าโมเดลใช้เหตุผลถูกหรือไม่
- แบ่ง train และ evaluation ตามเวลา เลือก threshold จากอดีตแล้ววัดกับอนาคตให้เหมือน production
- ตรวจ lineage ของทุก feature กัน label leakage ที่อ้อมผ่าน lookup, cache หรือ aggregate
- เขียนกติกาภายในทีมออกมาให้ชัด สิ่งที่คนทำงานรู้กันเองอาจไม่มีอยู่ในนิยามที่ส่งให้โมเดล
- วัด calibration และ distribution อย่าเชื่อ probability หรือ metric รวมโดยไม่เปิดดูพฤติกรรมรายกลุ่ม
- ออกแบบ human review เป็นส่วนหนึ่งของระบบ เคส confidence ต่ำหรือผลกระทบสูงควรส่งให้คนตัดสิน
บทสรุป
หลังลองกับข้อมูลจริง ผมมองว่า Jev น่าสนใจตรงที่มันอยู่กึ่งกลางระหว่าง rule engine กับ LLM แบบสร้างข้อความ มันรับภาษาธรรมชาติและใช้ judgment ได้ แต่ผลลัพธ์ยังอยู่ในรูปที่โค้ดควบคุมต่อได้
สิ่งที่ผมชอบที่สุดไม่ใช่ accuracy สูงสุด แต่คือความสามารถในการออกแบบระบบที่ยอมรับว่าไม่มั่นใจ แล้วส่งเคสยากกลับให้คนตรวจ ตรงนี้เหมาะกับงานที่ความผิดแต่ละฝั่งมีต้นทุนไม่เท่ากันมากๆ
ส่วนที่ต้องระวังคือ AI ไม่ได้เติมข้อมูลที่ไม่มีให้เรา ถ้าคำตอบอยู่ในฐาน spam ก็ต้องเปิดฐานข้อมูล ถ้ากฎธรรมดาตรวจอีเมลได้ก็ใช้กฎธรรมดา ส่วน probability calibration แม้รอบนี้จะทำได้ดี ก็ยังต้องวัดใหม่เมื่อ domain, ภาษา หรือข้อมูลเปลี่ยน
ผลการทดลองรอบนี้ยังไม่ทำให้ผมเปิดระบบตัด lead อัตโนมัติเต็มรูปแบบทันที ฐานตัวอย่างฝั่งที่ตัดเป็น spam เองยังน้อย และ recall ยังมีข้อจำกัด แต่ผมเห็นจุดที่เอาไปลดงาน manual review ได้ชัด คือกลุ่มคนจริงที่กรอกข้อมูลเลอะเทอะ โดยเฉพาะชื่อที่มีตัวเลข (แต่ถ้าว่ากันตามจริง ช่วยได้น้อยมากๆ ผมอาจจะแค่ปรับ rule เช็คให้ดีขึ้น)
สำหรับผม คำตอบว่า ยังไม่ควรใช้ Jev เต็มระบบ ไม่ใช่ว่ามันไม่ดีนะครับ มันคือผลลัพธ์ที่มีค่าที่สุดของการทดลอง เพราะอย่างน้อยเรารู้ว่าควรใช้ตรงไหน ไม่ควรใช้ตรงไหน และต้องเก็บหลักฐานเพิ่มอีกเท่าไร
การทดลองทั้งหมดเขียนด้วย Python มี test 137 ตัว และตัวเลขในบทความมาจากการรันกับข้อมูลลีดจริง 788 รายจาก 38 สัปดาห์ ชื่อบุคคลทุกชื่อที่ใช้เป็นตัวอย่างเป็นข้อมูลสมมติ
ผู้อ่านได้อะไรจากบทความนี้
- รู้จัก Jev และ System One model ว่าเหมาะกับ typed decisions มากกว่างานสร้างข้อความ
- เห็นตัวอย่าง evaluation บนข้อมูลจริง ตั้งแต่ temporal split, confidence interval, precision, recall ไปจนถึง calibration
- แยกบทบาท AI กับ deterministic system ได้ชัดขึ้น เพื่อไม่เอาโมเดลไปทำงานที่ code หรือ database ทำได้ดีกว่า
- รู้จัก data leakage แบบอ้อมๆ ซึ่งซ่อนอยู่ใน feature, lookup และ cache ได้
- อ่าน metric อย่างระวัง โดยดู distribution, class behavior และต้นทุนของความผิดแต่ละแบบร่วมกัน
- ออกแบบ human review ได้เป็นระบบ แทนการบังคับให้ AI ตอบทุกเคส
แหล่งข้อมูล
- TypeSafe AI Documentation
- System One model
- Choice, Score และ Noul primitives
- Probability และ confidence